
开题报告用 AI 写会被问穿吗?假引用撤稿、空题目与评委三问
写作方法·Thu Oct 15·PCPASS 指南
开题报告用 AI 拼,被问穿的不是文采,是两样东西:题目为什么可行,和引用是不是真的存在。
一位博士生用工具把文献编号自动转成格式化参考文献,投稿前没有逐条核对,论文发表九个月后被期刊撤稿——十几条参考文献大部分在公开数据库里检索不到。这是 2026 年 7 月发生在美国科学院院刊(PNAS)的真实撤稿,不是假设出来的警告。开题季把这份通报找出来读一遍,比任何「AI 写作技巧」都管用:开题报告里 AI 拼出来的题目、研究现状和引用,在答辩现场暴露的方式和这份通报一模一样——评委问一句「这篇文献你读了原文吗」,就结束了。
先给动作序列:引用逐条入库核对,题名或 DOI 在知网、PubMed 或 Web of Science 检索,查不到的先删或换;研究现状按主题重组,每篇文献写明样本与口径;题目用对象、变量、场景三层限定收成能做的小题;AI 使用按学院口径披露;检索记录和草稿版本全部留档。
一、AI 拼的开题报告会被发现吗?
会被发现。AI 拼开题报告的痕迹集中在题目、研究现状、引用三处,评委追问「数据从哪来」「这篇文献你读了原文吗」两个问题,就足以暴露。三处信号各有对应:
题目大而空。生成式工具给出的题目多半是「某因素对某对象的影响研究」这种全称判断,对象宽泛、变量不明、没有场景。这类题目文献如海看不完、数据拿不到,评委只需要问「你的切口在哪」。
研究现状是作者排队。「张三(2019)提出了 X,李四(2022)认为 Y,王五又指出 Z」——句式等长、结构重复、句与句之间没有信息起伏,整段是正确的废话,看不出作者自己的比较和取舍。AI 生成的现状综述几乎全是这个形态,因为它统计上最像「综述」。
引用成片查无此文。这是最致命的一处,也是后面撤稿通报的主题:模型会编造看起来完全规整的参考文献——作者、年份、期刊、卷期页码齐全,检索不到。
| 信号 | 答辩现场的对应追问 | 修复动作 |
|---|---|---|
| 题目大而空 | 你的切口在哪、数据从哪来 | 三层限定:对象→变量→场景 |
| 现状作者排队 | 这些研究吵什么、缺口在哪 | 按主题分类,每类收在缺口上 |
| 引用查无此文 | 这篇你读了原文吗 | 逐条题名或 DOI 入库核对 |
二、评委的三个必问题,正好打在 AI 的短板上
开题答辩翻来覆去问三个问题:这个题目为什么值得做、数据怎么拿、方法为什么合适。这三个问题共同的特点是都要落到「你的」——你的对象、你的变量、你的样本。AI 能生成通顺的句子,但生成不了你还没做过的调查:样本量多少、问卷发到哪、访谈约到谁、数据哪一年、口径怎么定。答辩时评委顺着任何一个数字往下追第二层,「这个比例是怎么算出来的」,拼出来的报告当场见底。
所以 AI 痕迹被问穿的本质不是「文风像」,是内容空心:题目、现状、方法三处都是可复述的通识,没有一处是只有你才知道的事实。三层限定法和「方法写到怎么用」的完整做法,站内《开题报告怎么写才不被毙》拆过,这里只说边界:限定题目、设计方法这两件事,工具可以给参照,决定必须自己下。
三、假引用的代价,已经到撤稿和撤职称的程度
开题阶段最容易心存侥幸的是引用——「先编上,后面再补」。但这一年公开通报里,假引用的代价从重写论文一路涨到撤稿、撤职称、进失信库,四份通报把链条补全了:
| 通报 | 事项 | 后果 |
|---|---|---|
| PNAS 撤稿通报(2026-07) | 作者用 Microsoft Copilot 自动转换参考文献、投稿前未核实,十几条引文大部分检索不到;插图也由生成式 AI 完成 | 论文撤稿;通报写明作者对 AI 生成内容负全责并须核实 |
| 香港大学团队撤稿(2025-12,Springer 期刊) | 调查确认部分引文为 AI 生成的虚构文献 | 论文撤稿;通讯作者卸任行政职务 |
| 《自然》审计(2026) | 筛查约 250 万篇论文、9700 万条参考文献:4046 条虚假引用分布在 2810 篇论文 | 虚假引用率三年陡升(每 2828 篇 1 篇 → 每 458 篇 1 篇 → 每 277 篇 1 篇);98.4% 涉事论文未撤未改 |
| 高校职称通报(2026-09) | 教师专著多处与他人著作重合、引文标注不实,两篇英文论文引用无关文献 | 撤销正高职称;三十六个月禁申报晋升;记入科研诚信严重失信数据库 |
| 研究生学位论文 AI 工具使用指南(2026-05) | 行业组织发布的学位论文 AI 使用规范 | 责任口径:谁使用、谁负责;学位申请人对全部内容负最终责任,核心论点与创新贡献必须由申请人自己提出 |
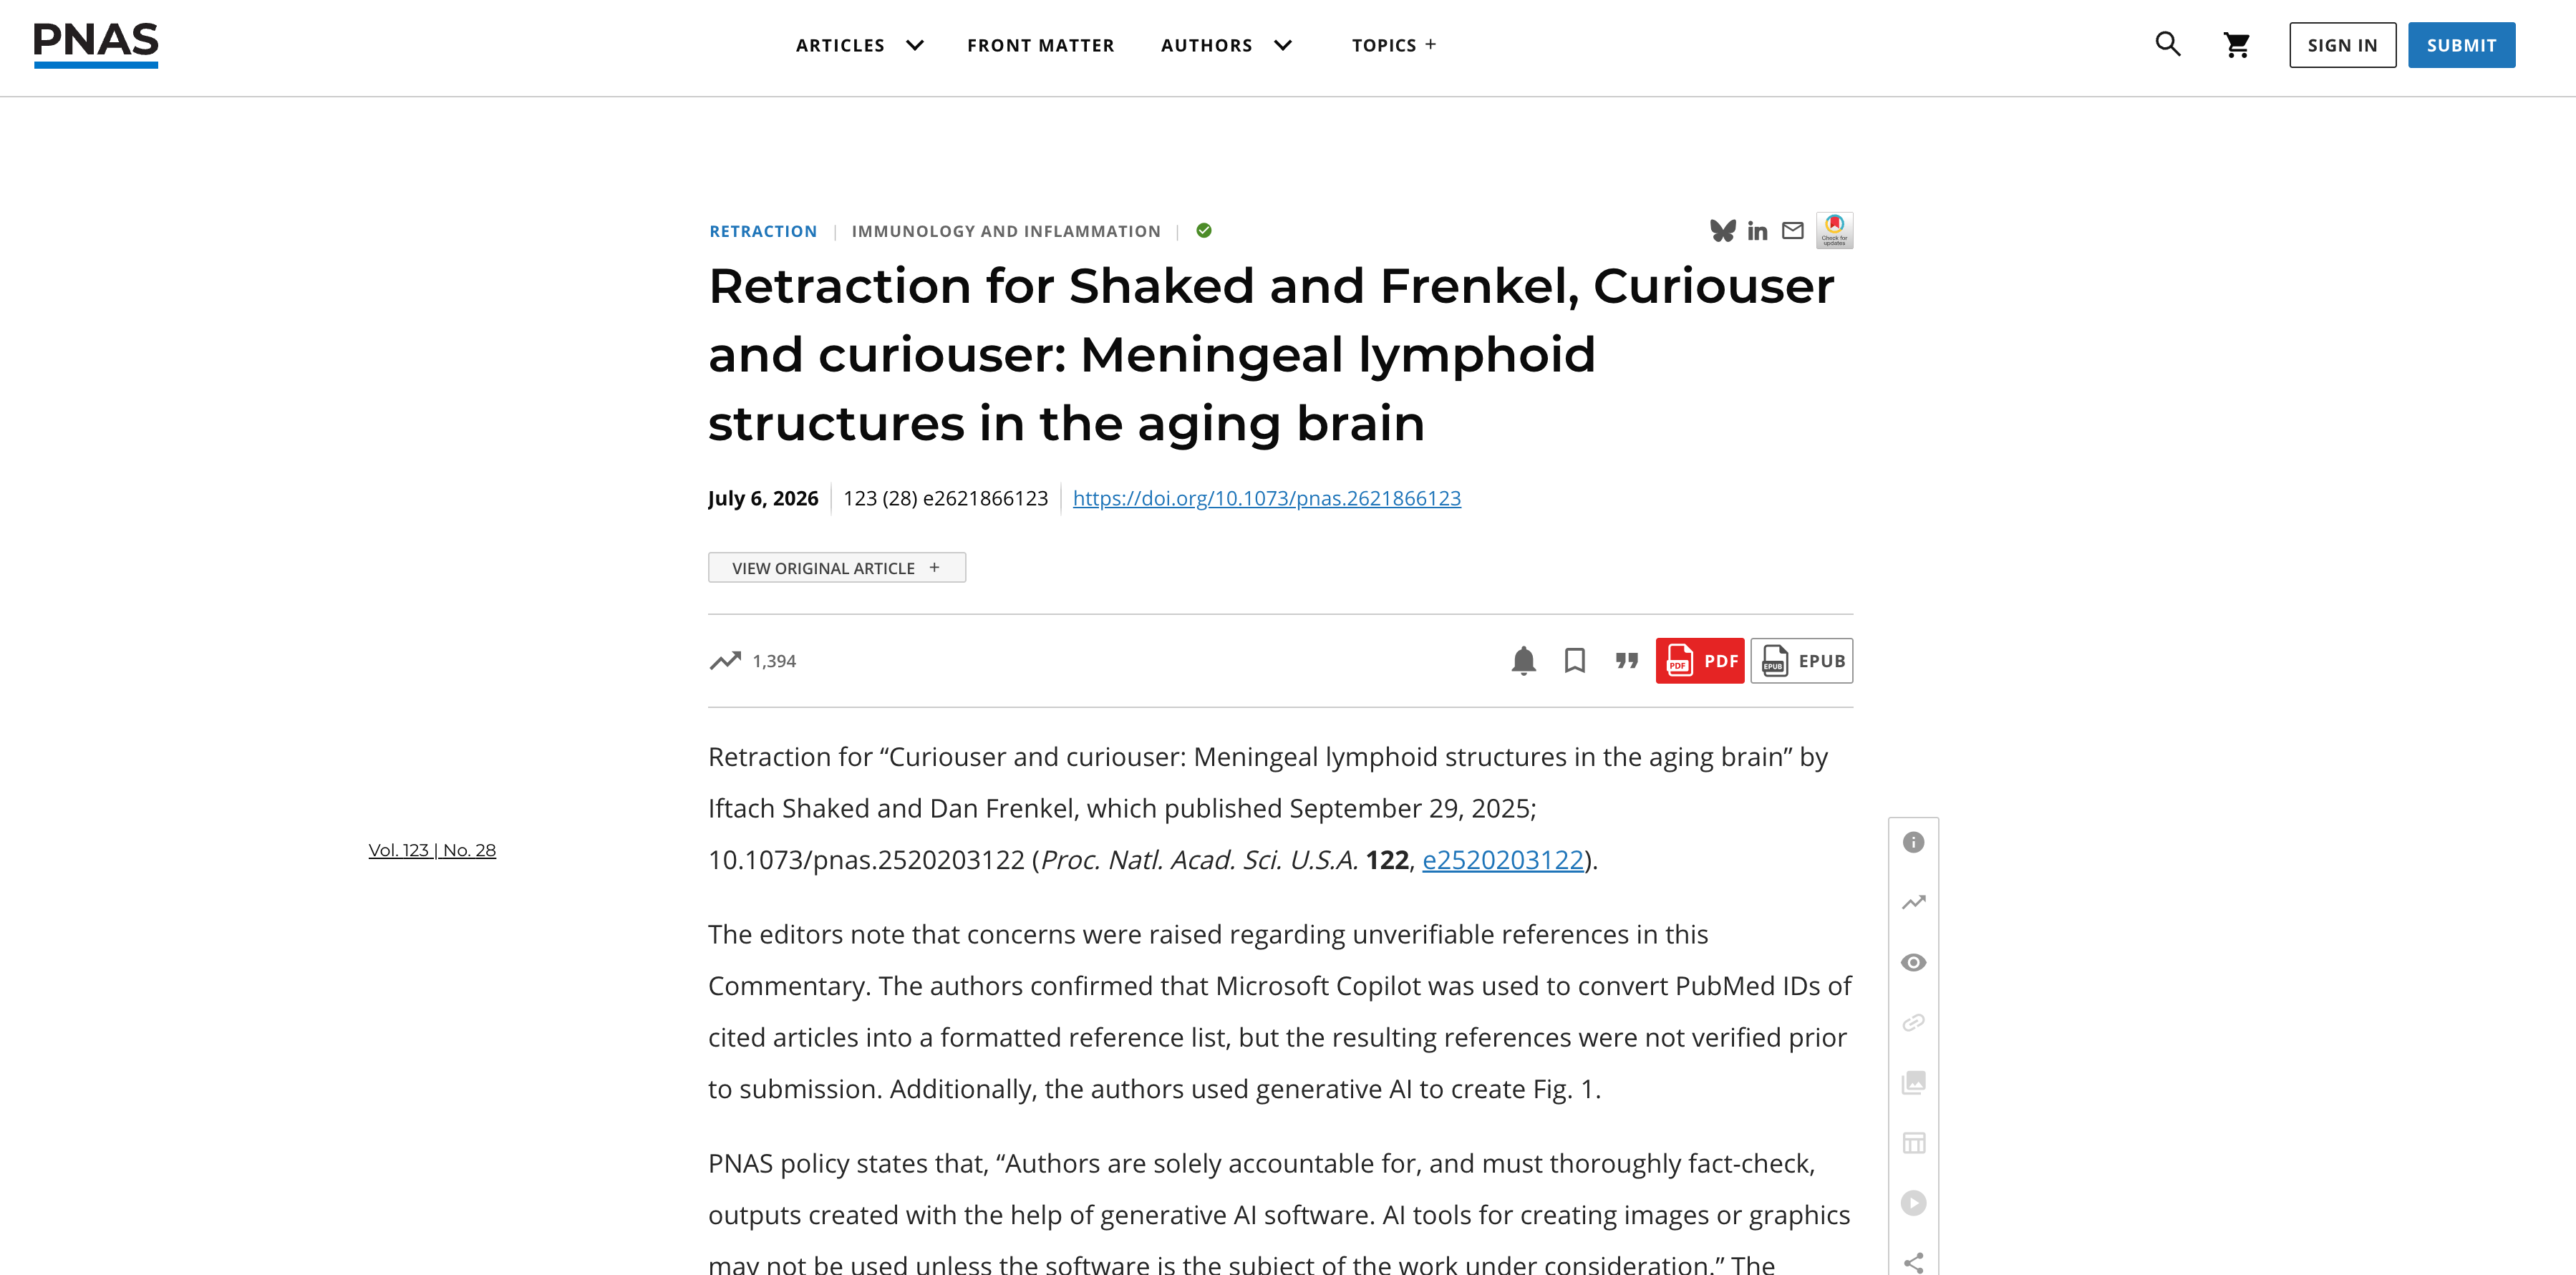
来源:PNAS 官网撤稿通报
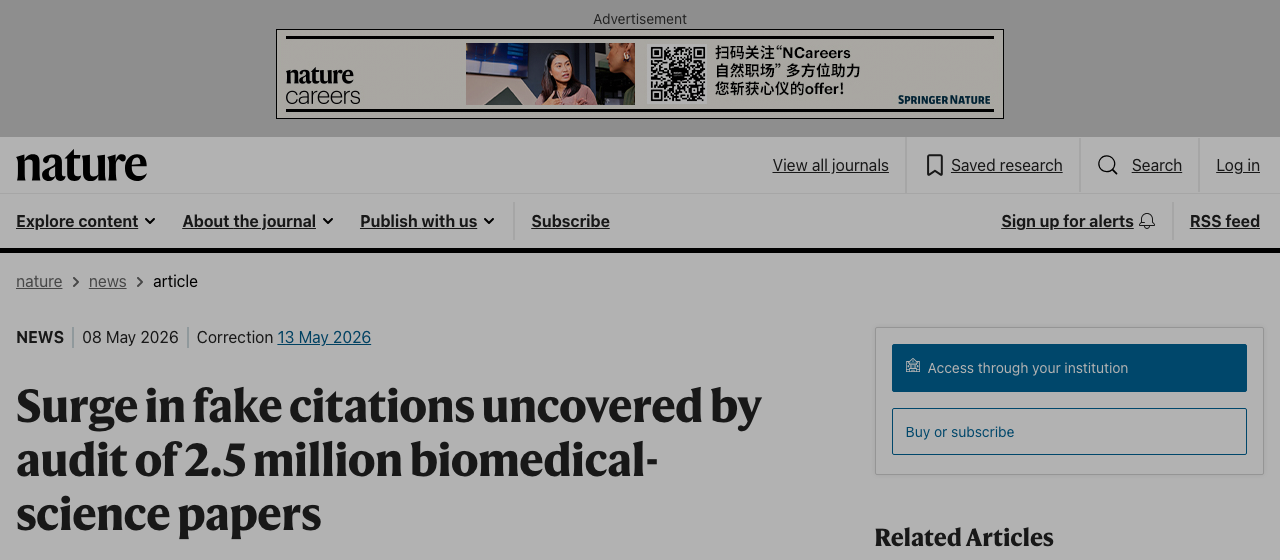
来源:《自然》官网
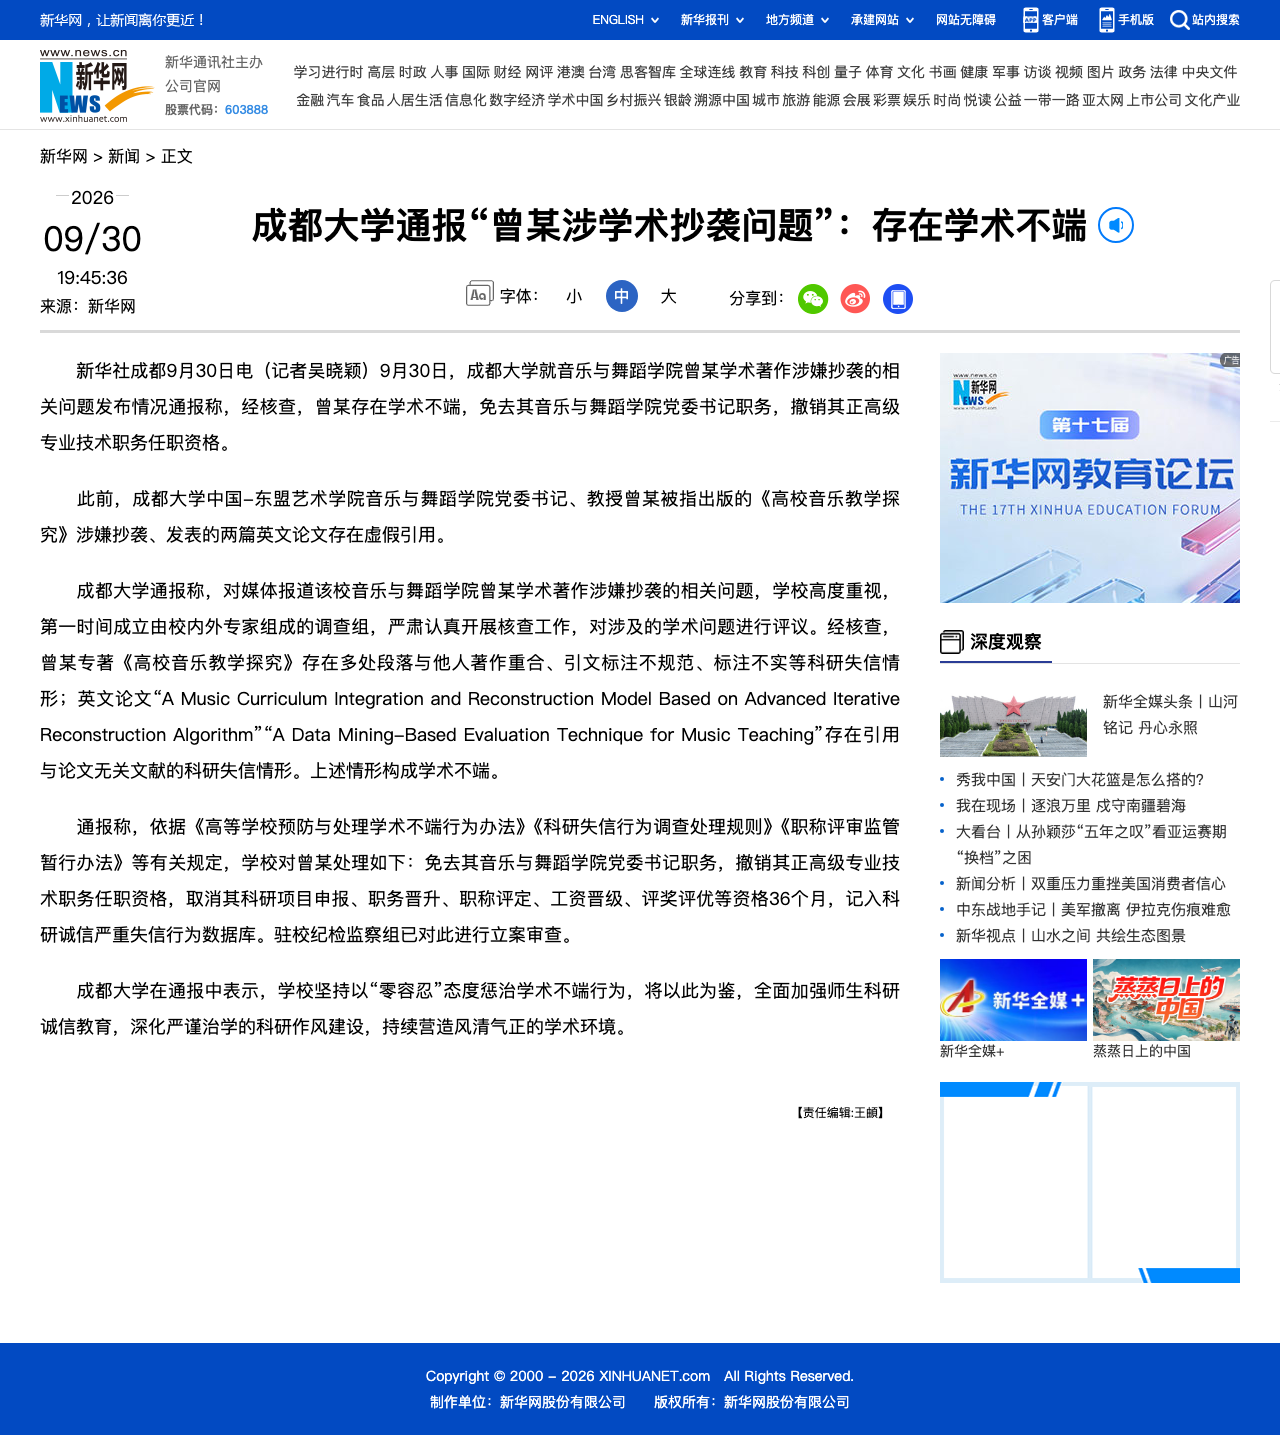
来源:新华网
把《自然》那行数字再读一遍:假引用从每两千八百多篇一篇,涨到不足三百篇一篇,只用了三年——这条陡升曲线和生成式工具的普及曲线是同一条。机器编出来的参考文献长得最规整,也最经不起检索,这不是概率问题,是方法问题。开题阶段编造的引用同样算数,终稿要一字不少地继承这个阶段的综述。
四、AI 在开题阶段的正确用法
边界比禁令更有用。查新检索可以借力:让工具帮你扩展关键词、翻译摘要、整理检索式,检索这一步它比人快;但每一条进入研究现状的文献,必须自己打开原文,记下样本、年限和结论条件。格式整理可以借力:参考文献的著录格式、表格排版、术语统一交给工具,然后逐条与数据库核对。综述的评析句不能借力:哪两派在吵、吵到哪一年、你采信谁的口径——这些句子答辩时要脱稿说出来,而它们恰好也是检测器眼里人味的来源。使用留痕:哪一步用了什么工具、做了什么,按学院口径披露,检索历史和草稿版本留档。
五、开题前一晚的自查
引用逐条入库:题名或 DOI 在对应数据库检索,查不到的先删或更换,不带着侥幸上会。研究现状每类收口:按主题分类的组织里,每一类最后一句是缺口,不是「具有重要意义」。题目三层限定:对象、变量、场景各收一层,切口小巧、数据可达、方法匹配三条自检。AI 披露与留痕:按学院通知的口径写明使用范围,检索记录、大纲版本、文献笔记保留到答辩之后——它们是核查与申诉时最直接的证据。
开题报告真正防身的不是「不像 AI」,是每一句都经得起第二层追问:数字有来源、引用有原文、题目有切口。做到这三条,用没用工具都站得住;做不到,文采再好也一样被问穿。