
综述/文献综述为什么AIGC特别高?|pcpass降ai
问答指南·Mon Aug 03·PCPASS 指南

文献综述章 AIGC 疑似度偏高,多数时候不是「抄」,而是体裁本身——「学者们普遍认为」「综上所述」这类转述模板句,密度天然高于论文其他章节,正好落在检测器的判定区间。有效的改法不是整章口语化,也不是逐句换同义词,而是三步:先按段落级报告定位高疑似段,再按观点重组、把泛转述换成可核验的文献信息、删掉空泛评价,最后用学校指定的同一系统同口径复测综述章。
先看场景,说明这件事为什么值得认真对待。
东北石油大学公布本学年抽检结果反馈:覆盖 61 个本科专业,抽取 378 篇毕业设计(论文),占毕业生总数的 7.24%,大约每十四篇抽一篇。抽检不是走过场,综述章作为每篇论文的必设章节,就在这个池子里。
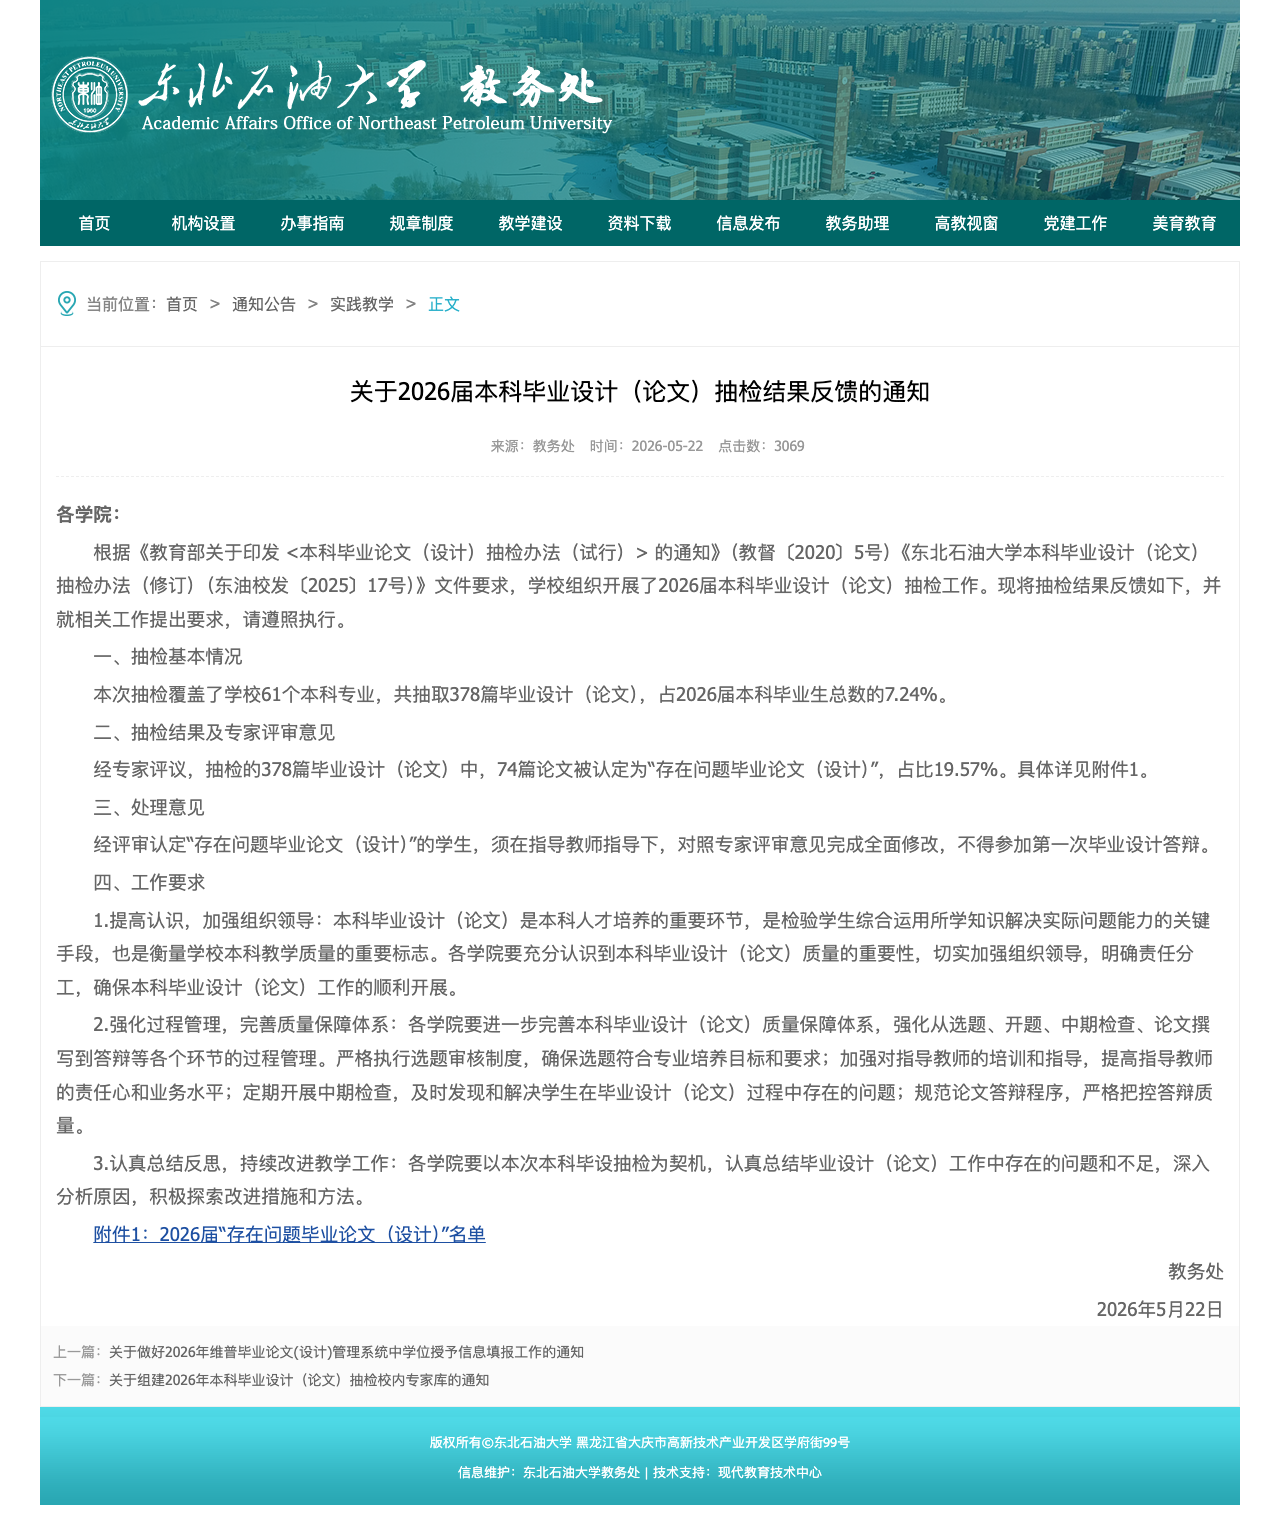
来源:东北石油大学教务处官网
再看一个脱敏案例:一位学生的论文查重只有 6%,综述一章却把全篇 AIGC 总分拽到 50% 多。他发来截图时附了一句「这章真是我敲的」。我们相信他敲过键盘——问题不在敲没敲,在综述这种体裁对检测器太「客气」了。写成什么样容易被误判,自己写的论文为什么也被判 AI 一文有更大的误判图谱。下面按原因、判读、改法、复测四层展开。
一、转述腔的三个特征,每一个都踩在判定区间上
| 特征 | 综述里的典型写法 | 为什么像机器生成 |
|---|---|---|
| 模板句开场 | 「学者们普遍认为」「综上所述」「近年来,随着……」 | 高频套话,语料里出现过百万次,可预测性极高 |
| 人名流水账 | 「张三(2019)提出了 X,李四(2022)认为 Y,王五又指出 Z」 | 句式等长、结构重复,句间没有信息起伏 |
| 有转述无评述 | 每篇文献各占一段,谁说了什么很全,就是没有比较和立场 | 通篇「正确句」连成片,没有作者自己的判断 |
这三条叠加,就是综述章的默认形态。写的人觉得规整,检测器看到的是低困惑度、高规律性的文本——和模型输出的统计特征高度重叠。
二、检测器是按段落判的,不是按句
主流系统的报告结构是分层的:高度疑似、中度疑似、轻度疑似三档占比,再往下一层是段落/片段疑似度。常见实现是给一个合并段打一个分,再把分数显示到段内各句上,界面看着像句级,实质仍是段级判定。各字段的读法见 AIGC 检测报告怎么看。
这对综述章有两个直接推论。第一,别只盯总分——综述章往往就是那几个贡献了大部分超标字数的高亮段,把这几段打穿,比通篇润色有用得多。第二,只改半句同义词基本没用,段级判定认的是整段的信息结构。
三、红线参考:期刊线比学位线更明确
| 场景 | 口径 | 来源 |
|---|---|---|
| 期刊退稿线 | 《社会科学辑刊》主编口径:AIGC 疑似度超 20% 直接退稿 | 新华网转载央视网报道(2025-04-28) |
| 期刊投稿筛查 | 中华医学会杂志社自研系统投稿时自动查一轮、修改稿再查一轮,疑似度直接报给编辑;准确率 80% 以上 | 同上 |
| 投稿面占比 | 该社系列期刊近半年超 12% 的投稿,AI 撰写内容占比达 5% 以上 | 同上 |
| 学位抽检 | 东北石油大学 2026 学年抽检 378 篇、占 7.24%(约十四抽一) | 东北石油大学抽检结果反馈(2026-05-22) |
| 不合格后果 | 宿迁学院 2026 年 5 月:抽检认定不合格,取消首次答辩资格 | 宿迁学院教务处公告 |
期刊这条线值得单独说一句:综述和引言是投稿筛查最先扫到的章节,因为它们是全文里「转述已发表文献」密度最高的部分。投期刊的作者,综述章建议按 20% 这条线倒推着压。
四、学术写作本身就是公认难测的域——所以更要同口径复测
检测难度和文本类型强相关。C-ReD 基准的五个域构成如下:
| 域 | 条数 | 语料来源 |
|---|---|---|
| 新闻 | 3,000 | THUCNews |
| 问答 | 2,956 | 知乎 KOL |
| 影评 | 2,960 | 豆瓣 |
| 作文 | 1,081 | 高考作文 |
| 学术写作 | 500 | ChinaXiv 论文的题名、关键词、摘要与引言 |
| 合计 | 12.8 万条 | AI 侧文本由九个模型生成;C-ReD 于 2026 年发布 |
五个域的难度并不平均:问答、影评这类结构化文本最好分开,新闻次之,学术写作被排到了最难测的位置。论文给出的原因很直白——模型在这些域里输出越流畅连贯,典型的机器痕迹就被抹得越干净。综述章恰好属于这个最难测的域,同一章在不同系统之间的分数波动也最大。波动大反而简单:改前用哪个系统测,改后就还用哪个,中途换了系统,对比数字没有意义。
五、动手前先把报告拆开
拿到报告先做三件事:排除标题、目录等不计区域;把正文段落按疑似度从高到低排序;标出接近「高度」档的前几段。经验上,前面几个高亮段就贡献了全文大部分超标字数。综述章的高疑似段通常集中在两处——章首的背景铺垫段,和中段成片的文献转述段。
有一类段落反而不用慌:写过「两派争议到底吵什么」的评述段,分数往往不高。这不是运气,是这类段落里出现了作者自己的比较、取舍和立场,信息结构不再是转述模板。
六、改法一:按观点重组,不按人名记流水账
| 原写法 | 问题 | 改写方向 |
|---|---|---|
| 张三(2019)提出 X;李四(2022)认为 Y;王五(2023)指出 Z | 三句等长、纯转述 | 把三篇按「吵什么」归成两派,写清分歧点在哪 |
| 学者们普遍认为 X | 无主体、无范围的空转述 | 写明是哪几篇、在什么样本和口径下得到 X |
| 综上,X 领域发展迅速 | 空泛总结 | 换成具体判断:已解决什么、卡在什么、本文接哪一派 |
重组的原则是让段落里出现结构:分歧、演变、缺口。同样这些文献,一个字没多引,信息结构变了,段落的统计形状就变了。
七、改法二:把泛转述换成可核验的细节
「样本年限」是个典型缺口。写「已有研究对此有不同结论」不如写「2019 年那篇用的样本到 2018 年为止,2022 年那篇把年限延到了 2021 年,结论翻过来」。年份、样本量、统计口径、适用范围——这些具体信息只有真读过文献才写得出,也正是检测器眼里「人味」的来源。
前文那个查重 6% 的案例,改红段时做的就是这样几件事:空开篇砍掉,争议点提前,不写「谁说了啥」的流水账而是写自己跟哪边,2019、2022 两篇的样本年限补进去。引用一条没动。
八、改法三:删空泛评价,补一句自己的立场
「具有重要参考价值」「值得深入研究」这类空泛评价,删了不影响信息量,还占着疑似度。腾出来的位置写一句具体的:这篇的局限在哪、你为什么不跟它的口径、它和另一篇矛盾时你采信谁。综述章的评述密度上去了,整章的形状就从「文献清单」变成「文献综述」。
九、两条不奏效的路,别浪费时间
整章口语化不奏效。有学生把综述改成了贴吧语气,分数黏着不动——口语化破坏的是学术规范,不是生成特征,检测器认的不是「文绉绉」,是「可预测」。同理,逐句同义词替换也基本无效:段级判定下,半句的词汇变化改变不了整段的信息结构。这两条路的问题都在于没有触及转述腔的根源,改法的边界见 降 AI 不必口语化。
十、脱敏对照:两例的初测与复测
| 案例 | 初测 | 动了什么 | 复测 |
|---|---|---|---|
| 综述章拖垮总分 | 查重 6%,综述章把全篇 AIGC 总分拽到 50% 多 | 砍空开篇、争议点提前、按派别重组、补样本年限;引用未动 | 同口径复测综述章过线;查重顺手再跑,未反弹 |
| 直接交稿被退回 | 整篇初测疑似度约 88%,高疑似集中在综述与结论,方法章几乎不高 | 只改综述归类表述、结论空泛总结,补入本组实验参数 | 复测降至约 19% |
第二个案例来自 DeepSeek 起草后怎么交稿 的公开记录,场景不同(整篇直接交 vs 本章局部改),放在这里作量级参照:高疑似集中在综述与结论,是这两例共同的特征。
十一、复测的三件事
第一,同一系统、同一口径。改前用哪个系统测,改后还用哪个,数字才可比。第二,AI 降了顺手再跑一次查重——综述章骨架一变,前后句的用词重合度会挪动,查重和 AIGC 两套机制独立计分,别只盯一头,两项都要查时的顺序见 论文双查全攻略。第三,先报告后工具:没有段落分布就整章丢给改写,最容易把本来正常的部分改坏。
十二、交稿前自查清单
| 检查项 | 合格标准 |
|---|---|
| 综述章段落排序 | 高疑似段已按报告定位,前几段已处理 |
| 人名流水账 | 已按观点/派别重组,无三连等长转述句 |
| 具体文献信息 | 年份、样本、口径至少补进两处 |
| 空泛评价 | 「具有重要参考价值」类句已删或已具体化 |
| 评述密度 | 至少一处写明自己的立场与采信理由 |
| 口语化 | 全章保持朴素书面语,无贴吧体 |
| 复测口径 | 与初测同系统同口径,综述章单独看段落分 |
| 查重联动 | 复测时查重同步再跑一次 |
综述章被标红,多数时候是体裁问题,不等于整章代写。按段定位、按观点重组、补具体信息,比吓得整章重写两万字实在得多。
方法笔记
这篇的长文在本站。步骤和检查项集中在 论文查重与 AIGC 自查笔记,按主题查找见 笔记站指南目录。检测和改写仍在本站。