
DeepSeek 起草的论文交稿前检查什么?段落分工、数据验证与学校口径
问答指南·Wed Oct 07·PCPASS 指南

先说结论:DeepSeek 起草的稿子能不能交,取决于交上去的是「生成后直接粘的」还是「起草后重写过的」,两者相差一个数量级。交稿前要做的检查按三步走:先分工——方法与数据只核对整理,引言、文献综述、结论照方法论自己写;再做数据验证——数字、口径、版本逐项核对;最后按学校指定口径复测,及格线只认本校通知。适合正在用 DeepSeek 对话框或 DeepSeek Harness(DSH)起草毕业论文、临近提交的本科生和研究生。
「DeepSeek 起草」现在有两种形态。对话框一问一答,自己复制进 Word,段落短、模板腔一眼能看出来,好在容易逐段改。更省事的路线是把整个写作任务交出去让工具自己跑,DeepSeek Harness(DSH)走的就是这条路——省下来的是时间,带进去的是模板腔:成稿结构更整齐,机器痕迹也更均匀,检测时未必更安全。
| 项 | 说明 |
|---|---|
| 版本 | DeepSeek Harness v0.2 预览版,2026-09-29 发布,有 macOS / Windows 桌面端 |
| 用法 | 把题目、文献 PDF、写作要求整个交出去,它自己分步跑资料整理、数据分析、图表 |
| 插件 | 用 npm 包名安装;官方口径约六成用户在用第三方插件 |
交稿前先分工:方法数据核对,引言综述结论自己写
交稿前最重要的检查不是通读全文,而是先分工:方法、数据、结果三块做核对与验证,引言、文献综述、结论三块照方法论自己写,不要直接用成稿。
| 段落 | 怎么处理 | 为什么 |
|---|---|---|
| 方法、数据、结果 | 不重写,核对细节:参数、表格、数字逐一对回原始记录 | 有你的实验操作和真实数字,检测最难判「生成」 |
| 引言 | 不用成稿,照方法论自己写 | 观点通用、句式规整,高疑似重灾区 |
| 文献综述 | 不用成稿,照方法论自己写 | 逐句换词没用,要按你的问题重组文献 |
| 结论 | 不用成稿,照方法论自己写 | 空泛总结最像模板 |
后三段里,DSH 的价值是方法论而不是句子:它怎么把题目拆成子问题、按什么顺序组织论证、综述按什么维度给文献归类,这个骨架可以借鉴;成稿句子一句都不要搬。可行的分工是让它只交大纲——每段要回答的问题、论证顺序、归类维度——每一段自己写出来。一句话写不出来的段落,往往就是最像 AI 的段落,说明这一段本来就没有你自己的判断。
方法与数据:先整理,再验证
方法与数据不用重写,要做的是把「确实是我自己做的」变成可核对的材料:先整理,再验证。
| 整理什么 | 动作 |
|---|---|
| 表格与正文数字 | 逐格对回原始记录;正文里的样本量、百分比、均值与表格一致 |
| 口径 | 单位、有效数字、分组命名全文统一,同一组数据不出现两种叫法 |
| 原始材料 | 实验输出、问卷、日志按章节归档,保留带时间的原始文件 |
| 验证什么 | 动作 |
|---|---|
| 关键数字 | 抽 3~5 个复算一遍,每个能指到一条原始记录(导出文件或截图) |
| 版本 | 送检、查重、送审用同一个文件 |
| 图表 | 图注、表头、坐标轴与正文表述一致 |
整理和验证做的是两件事。其一,细节密度是正文里最强的「人味」来源:检测最难判成生成的,就是带真实参数和来路的数字。其二,归档的原始记录是误判申诉时的过程材料。方向要注意:核对、归档是对的;为了让数字「好看」去动数据,就跨进了学校明令禁止的红线。
版本一致:送检、查重、送审用同一个文件
版本一致性不是经验之谈,已经有学校把三条相关要求都写进了通知原文:
| 项 | 通知原文 / 内容 |
|---|---|
| 通知 | 山东建筑大学研究生院 2026-03-30《关于做好2026年春季学期研究生学位论文AIGC检测的通知》 |
| 版本 | 「提交AIGC检测的学位论文与查重和拟送审的学位论文应当是相同版本。」 |
| 红线 | 「严禁以删除、篡改等手段人为降低人工智能生成的内容比例」 |
| 处理 | 「一经发现与核实,学校将按学术不端相关规定给予严肃处理」 |
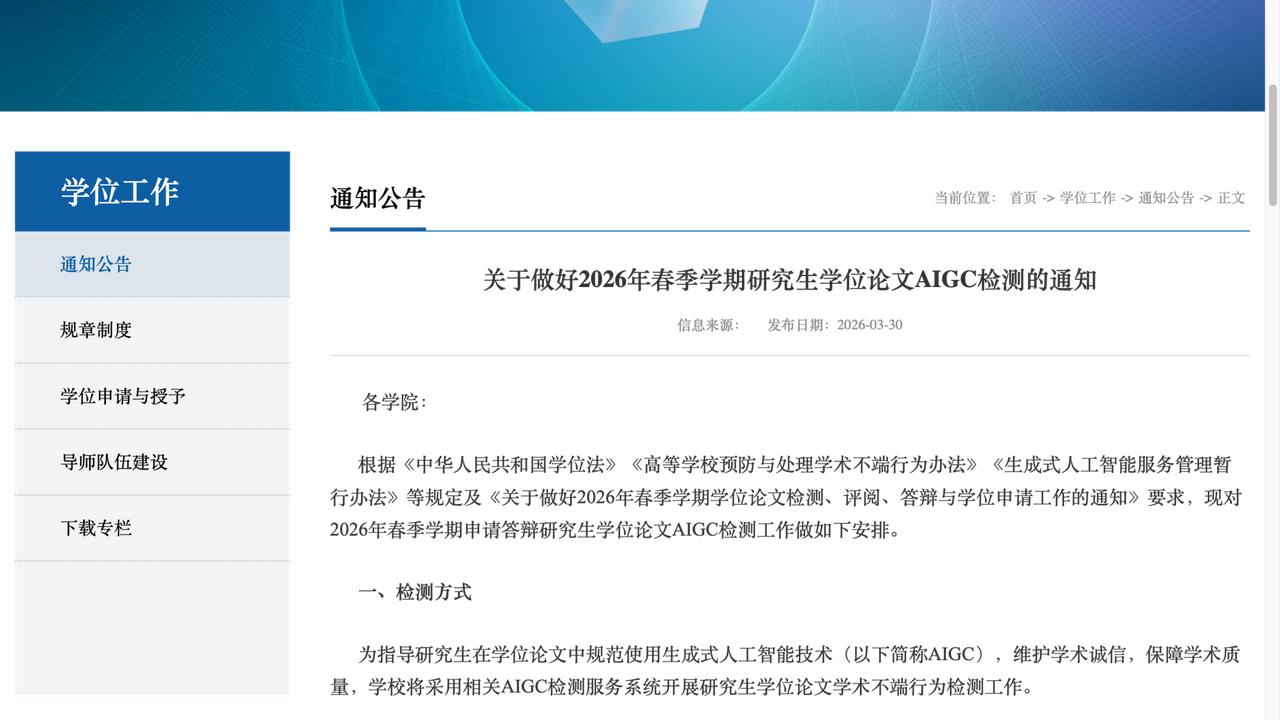
来源:山东建筑大学研究生院官网
版本对不上,报告对送审文本就没有证明力;改数据的性质比降 AI 严重得多,这是两条红线里更硬的那条。检测口径的更多差异见 AIGC 检测版本一致。
及格线只认本校通知,三所学校三套口径
AIGC 没有全国统一的及格线,三所学校的通知放在一起就能看出口径差多少。
| 学校 | 口径 |
|---|---|
| 山东建筑大学 | 2026-03-30 通知:智能生成内容比例原则上不超过 40%,超限预警并由学院组织专家复核;各学院抽检比例为申请答辩总人数的 20% |
| 南京财经大学 | 2026 届毕业设计通知:AIGC 检测内嵌毕设系统,智能生成内容比例原则上不高于 40% |
| 浙江财经大学 | 2026-06-15 查重通知:使用知网 TMLC2 系统,「我校仅承认本校所使用系统的检测结论」,校内外系统结论不同时送审风险由本人承担 |
系统、红线、抽检比例都是各校自定。学校用 A 系统,你拿 B 系统的「很低」当护身符,没有用。以研究生院或教务处通知为准:用哪家系统、多少算过、单查还是双查,双查的先后顺序见 论文双查全攻略。
复测一轮一轮来:AIGC 和重复率同轮看
每改完一轮,按学校指定系统把 AIGC 和重复率同一轮复测,不要凭「觉得改好了」判断。看高疑似段是否真的下降,对照 AIGC 检测报告怎么看 里的字段逐段核对;重复率也要同轮复测——机械降重常把句子推得更像模板,AIGC 反而抬头,两者的互相影响见 降重和降AI互相影响。自测阶段走完「降重达标、降 AI、复测」,正式提交前再提前几天跑最后一轮,不要把学校终检当唯一机会。
从 88% 到 19%:改对段落就够了
一篇工科本科毕业论文只改综述归类表述、结论的空泛总结,并补入本组实验参数,总疑似度就从约 88% 降到约 19%——全文重写并没有发生。
| 项目 | 数值 / 说明 |
|---|---|
| 用法 | 绪论与文献综述用 AI 搭框架并大段粘贴;方法与结果为自己实验数据 |
| 初测 | 学院指定格子达,红线 30%;总疑似度约 88%,高疑似集中在综述与结论,方法章几乎不高 |
| 复测 | 只改综述归类表述、结论空泛总结,补入本组实验参数 → 约 19% |
数字只说明量级,换学校、换系统不会复现出同一个 19%。那篇案例从初测到定稿每一轮做了什么,用 DeepSeek 起草后怎么交稿里有逐轮记录;高疑似段具体怎么改句式,朴素学术陈述给出了成段对照。
被误判时:留过程材料,走学校流程
复测卡住或被误判时,先留过程材料、走学校的说明或申诉流程,比反复自测、反复付费检测更管用。
| 做 | 不做 |
|---|---|
| 留大纲、草稿版本、文献笔记、原始数据截图 | 为了「过检测」把句子改成磕磕巴巴 |
| 走学校的说明或申诉流程 | 反复自测、反复付费检测,越测越慌 |
整理与验证环节归档的原始记录,这时就是证据链本身。AI 使用到了什么程度算越界,见 AIGC 使用边界指南。
交稿前自查清单
正式提交前按这张清单过一遍,缺一项就先补一项再交。
| 自查项 | 标准 |
|---|---|
| 段落 | 引言、综述、结论是照方法论自己写的,不是粘贴成稿 |
| 数据 | 表格数字对得回原始记录;抽过 3~5 个关键数字复算 |
| 版本 | 送检、查重、送审是同一个文件 |
| 口径 | 复测用学校指定系统,红线按本校通知,不按网上数字 |
| 时间 | 最后一轮复测留在提交前几天,留出波动余量 |
DeepSeek 可以用来起草、搭框架、整理表述;「生成后直接交」和「起草后重写」是两条路,走第二条,交稿前逐项检查。