
C-ReD 深读:检测器为什么会在新模型上失效?三类方法、七种设定与四条局限
数据观察·Fri Oct 09·PCPASS 指南
来源:论文首页(arXiv 2604.11796)
姊妹篇《C-ReD 讲了什么》把这份 12.8 万条的中文检测基准按「做了什么、发现了什么」过了一遍:五个域、九个模型,新闻与学术写作最难检测,DeepSeek-R1 是最难测的生成器。本文往下钻三层——三类检测器各自靠什么工作、七种实验设定分别回答什么问题、四条论文自认的局限在技术上意味着什么。给想做检测或研究检测的人看,也回答一个更普遍的疑问:为什么同一个检测器,换篇文章、换个模型,分数就对不上了。
一、三类检测器,三种依赖
C-ReD 测了三类方法,它们失效的原因各不相同:
| 类别 | 代表方法 | 工作原理一句话 | 依赖什么 |
|---|---|---|---|
| 零样本(无训练) | Log-Likelihood、Entropy、Log-Rank、LRR、Fast-DetectGPT、Lastde/Lastde++、DNA-DetectLLM | 用一个固定的参考模型给文本「打分」:似然、熵、词序排名、概率曲率 | 参考模型与生成模型的分布接近 |
| 有监督分类器 | OpenAI Detector、RADAR、ReMoDetect、IMBD | 在标注好的「人写/AI 写」语料上训练判别器 | 训练数据的模型覆盖与新鲜度 |
| 大模型当检测器 | 8 个 LLM × 三种提示策略(普通 / 给上下文 / 给风格描述) | 靠模型自身的判断力,提示给多少信息决定发挥 | 提示里的上下文与风格线索 |
记住这张表的右下角三格,后面所有结论都能从它们推出来。
二、七种设定,各回答一个问题
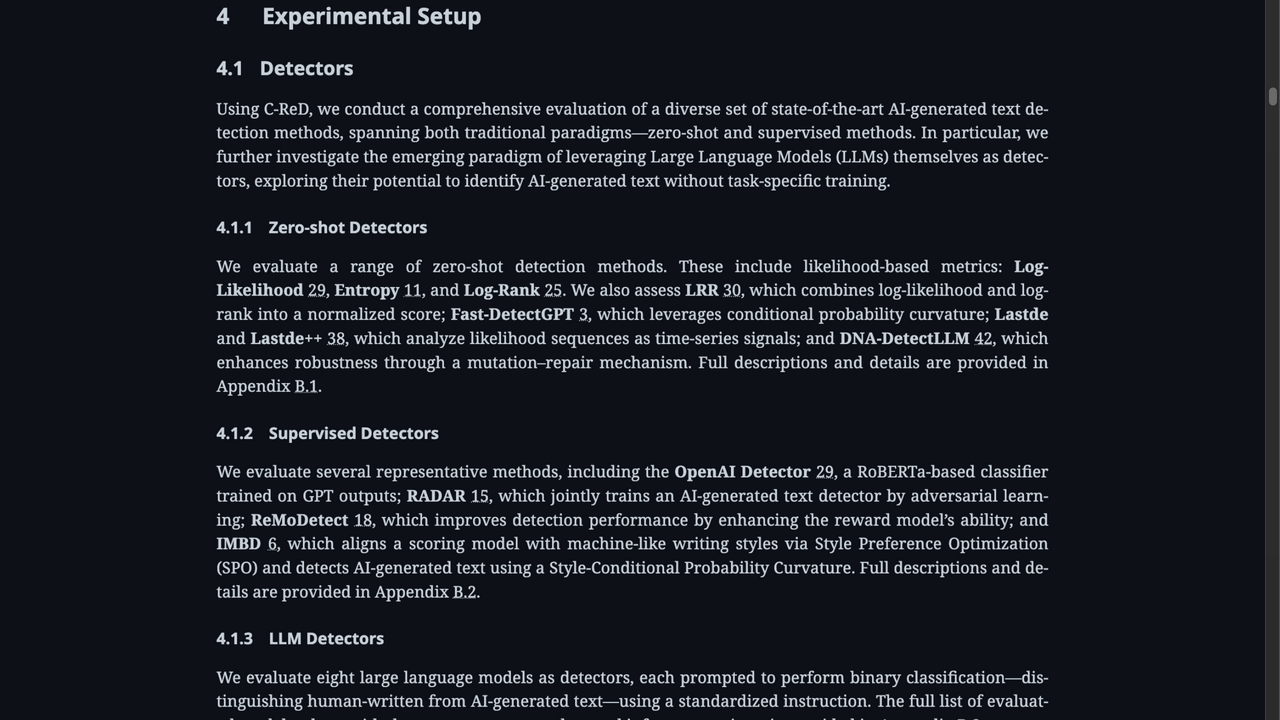
来源:C-ReD 论文(arXiv:2604.11796)
| 实验设定 | 回答的问题 |
|---|---|
| 通用评测(域与生成器都不给标签) | 检测器在「不知道对手是谁」时的真实水平 |
| 在 C-ReD 上微调后测分布内 | 给足同分布数据能到多少 |
| 微调后测分布外(未见模型) | 换个没见过的生成器还剩多少 |
| 固定生成器的跨域迁移 | 同一个模型换个别的文章还行吗 |
| 提示词复杂度消融 | 提示写得糙一点,难度变不变 |
| 繁体新闻测试 | 换个字素系统还成立吗 |
| 迁移到外部 M4 中文问答 | 这把尺子能不能借给别的数据集用 |
单看任何一格的数字都没有意义,意义在格子之间的差——这正是「检测器不是分数,是一张表」的含义。
三、零样本为什么「认生」
零样本方法的核心假设是:AI 生成的文本在参考模型眼里「过于顺滑」——似然偏高、熵偏低、词序过于可预测。这个假设成立的前提,是参考模型和生成模型的分布足够接近。C-ReD 的结果里,这条前提在新模型面前断了:遇到没见过的 LLM,参考模型会出现架构与风格的双重错配,老的有监督 RoBERTa 系检测器失效得更彻底,因为它们是用较早、质量较低的 AI 文本训练出来的——训练分布里压根没有今天这些模型的「口音」。
四、思维链为什么把 DeepSeek-R1 送上最难测的位置
论文给的归因是:R1 的思维链风格让输出更连贯、更像人的推理。放到第一节的框架里看,这相当于生成模型主动贴近了「人写文本」的统计形状——零样本打分的「过于顺滑」信号被稀释,有监督分类器的训练分布里也没有这种推理腔。两条路同时变窄,它在九个模型里垫底就不奇怪。
五、微调有效,但「完美迁移」做不到
在 C-ReD 上微调后,各域提升明显,对训练时未见过的两个模型(Claude-3.5-Haiku、Gemini-2.5-Flash)也有效,迁移到外部 M4 中文问答数据同样有提升——说明这份数据有资格当基础设施。但分布内与分布外始终存在小差距,论文自己的措辞就是完美迁移做不到。对工具开发者的含义很直接:新模型发布后,检测器需要一轮跟进式的数据与训练更新,这是持续性成本,不是一次性工程。
六、大模型当裁判:零样本不行,给了线索才行
八个大模型自己当检测器,零样本提示下基本不可用——连判定自己生成的文本都困难。但提示里给了上下文或风格描述后,准确率明显上升。
判断「像不像机器」需要参照系,参数记忆替代不了它。
七、提示词简化,难度几乎不变
消融实验里,把生成提示词写得更简略,检测难度几乎不变。含义是:强模型即便指令变少,也能写出「人味」足够的学术文本。想靠「把提示词写复杂」来解释检测难度的波动,这条路不通。
八、论文自认的四条局限
| 局限 | 技术含义 |
|---|---|
| 只有中文,多语言是未来工作 | 结论不能外推到英文检测场景 |
| 9 个模型会过时 | 今天的最难测榜单是快照,不是定论 |
| 对抗式提示不在覆盖范围 | 刻意绕检测的用法没被测——这恰是最难的场景 |
| 人类文本来源有限 | THUCNews、知乎、豆瓣、高考作文、ChinaXiv 覆盖不了中文写作的全部风格 |
九、我们的两条技术评论
第一,「把域和生成器拆开测」是这份基准对开发者最有用的动作。很多检测器宣称高准确率,但没说清是在什么域、对哪个模型;七种设定把两个变量分开后,检测器输出的是一张随条件变化的表。做检测产品的人应该照这个形状报告自己的能力边界,而不是报一个总分。
第二,零样本认生与微调可迁移两件事放在一起,指明了中文检测的工程现状:纯统计方法的时代在翻篇,跟进式微调是入场券,而入场券不保证满分——这正是国产模型进基准的价值,它们把「分布外」变成了常态测试项。
十、对写论文的人:一条推论就够
检测率不是一个可以跨域、跨模型直接引用的数字——这是全部实验设定合起来的唯一必读结论。落到动作上:第三方自测分数只作参考,终检以学校或期刊指定的系统为准;规范引用、AI 使用披露和写作留痕(大纲、草稿版本、文献笔记)比「押中哪个检测器」可靠得多。逐项的自查动作见姊妹篇末节,此处不重复。
边界与声明
本文没有做论文的复现实验;论文正文与附录未给出逐项 AUROC 数值,本稿也不复述具体分数。对检测方法原理的一句话概括(第一节)是公开常识层面的描述,用于帮助理解实验设计,不构成对各方法的完整刻画。论文的联盟与资助信息(国家自然科学基金 62301189、62576122、62571298,广东省基础与应用基础研究基金 2026A1515011139)照录,不代表我们对结论的背书。
| 项 | 内容 |
|---|---|
| 论文 | C-ReD: A Comprehensive Chinese Benchmark for AI-Generated Text Detection |
| 发表 | ACL 2026 Findings,arXiv 编号 2604.11796 |
| 作者单位 | 清华大学 / 南开大学 / 哈尔滨工业大学(深圳)/ 鹏城实验室 |
机构顺序不代表排名;口径以学校指定系统为准。
相关阅读:C-ReD 讲了什么:12.8 万条中文基准总览、AIGC 检测的国内研究地图、AIGC 检测报告怎么看、期刊的 AIGC 检测系统是怎么工作的。